Intel GPU D270: ставка на точность FP64 и память для HPC и ИИ
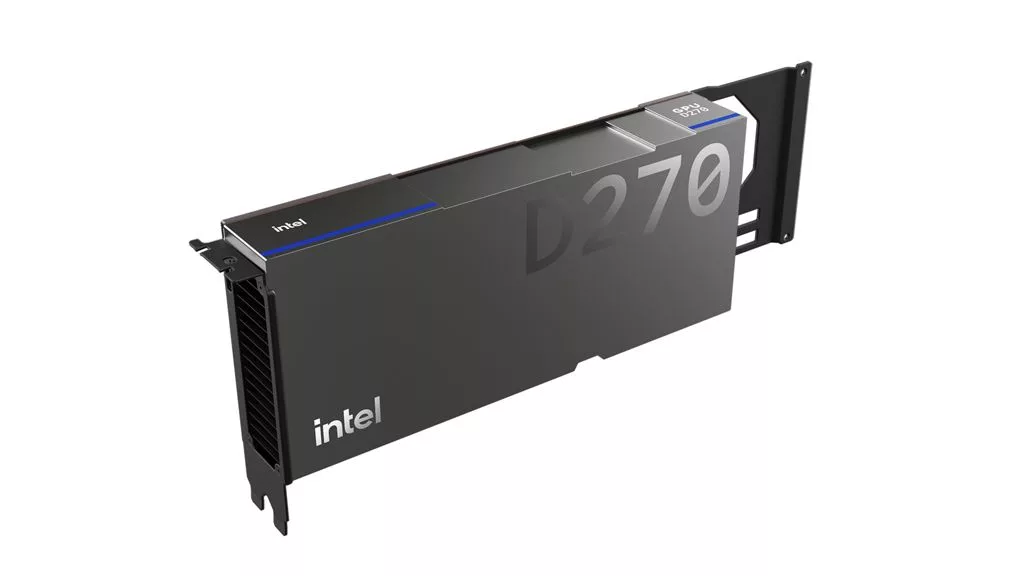
Мир высокопроизводительных вычислений (HPC) переживает фундаментальный сдвиг: классическое численное моделирование всё теснее переплетается с аналитикой и ИИ-инференсом. Intel делает ставку на этот гибридный подход, представляя GPU D270 (ранее известную под кодовым именем Crescent Island). Эта карта спроектирована так, чтобы закрыть разрыв между потребностями точных научных расчетов и скоростью работы современных ИИ-агентов, предлагая баланс между математической точностью и огромным объемом памяти.
Современные научные и инженерные процессы уходят от линейных сценариев. Сегодняшние рабочие нагрузки включают в себя «агентный ИИ» (agentic AI) — архитектуры, где модели данных и инструменты моделирования работают в автономных циклах, самостоятельно подготавливая входные данные и корректируя параметры симуляции в реальном времени. Для таких задач требуется гетерогенная инфраструктура, способная эффективно выполнять разные фазы одного процесса: от сверхточных расчетов до быстрого ИИ-инференса.
Точность FP64 и пропускная способность памяти
Для финансовых моделей и сейсмической визуализации критически важна точность вычислений: ошибки округления в двойной точности (FP64) могут привести к неверным результатам в долгосрочных симуляциях. Intel GPU D270 построена на архитектуре Xe 3P и оснащена 32 ядрами Xe и 256 движками Xe Matrix Extensions (XMX). Это позволяет разработчикам гибко выбирать точность: использовать низкую точность (от FP4 до FP8) для ускорения ИИ-инференса или переключаться на нативную FP64 для максимально точных математических операций.
Память в D270 — еще один ключевой фактор. Стандартная конфигурация предлагает 160 ГБ высокоскоростной памяти LPDDR5X с пропускной способностью 1.5 ТБ/с, при этом партнерские решения могут масштабироваться до 480 ГБ. Такой объем позволяет держать огромные массивы данных (например, волновые поля в сейсмике) непосредственно в памяти GPU, минимизируя задержки при передаче данных через шину хоста. При этом карта сохраняет стандартный форм-фактор PCIe 5.0 с тепловыделением 350 Вт, что позволяет интегрировать её в существующие серверные стойки с воздушным охлаждением.
Результаты в реальных задачах
Согласно результатам тестов на базе предсерийных образцов, архитектура D270 показывает преимущество в задачах, требующих высокой вычислительной плотности и работы с памятью:
Дезагрегация и ИИ в циклах HPC
Intel также продвигает концепцию дезагрегированного инференса. Вместо того чтобы заставлять один процессор выполнять все этапы задачи, рабочая нагрузка разделяется. В такой схеме Intel GPU D270 берет на себя ресурсоемкую стадию prefill (обработка входных данных и контекста), в то время как специализированные модули (например, SambaNova SN50 RDU) ускоряют стадию декодирования. Управление всем циклом берет на себя центральный процессор Intel Xeon 6. Такой подход позволяет ускорить работу «агентного ИИ» в симуляциях, не заставляя дорогостоящие вычислительные узлы простаивать в ожидании данных.
Важным аспектом является программная совместимость. Intel делает ставку на открытые стандарты (Open SYCL, Intel MPI, оптимизированный Fortran и C++), чтобы исследователи могли использовать D270 без необходимости переписывать существующий код под проприетарные экосистемы. Цель — обеспечить производительность «из коробки» (Day 0) для тех, кто уже использует стандартные ИИ-фреймворки и инструменты HPC.
Преимущество в задачах ИИ-агентов и LLM
Согласно предварительным данным, полученным на инженерных образцах (pre-production silicon), Intel GPU D270 показывает впечатляющие результаты в сегменте моделей, принимающих решения (decision-making models), а не просто генерирующих текст. В тестах с использованием Drex 2.0 задержка (latency) у D270 оказалась на 29% ниже, чем у NVIDIA RTX PRO 6000 Blackwell Server Edition. При этом энергопотребление ускорителя Intel составило 350 Вт.
В задачах, связанных с пропускной способностью больших языковых моделей (LLM), D270 продемонстрировала показатель в 1.12x по сравнению с конкурентом при работе с моделью Qwen 3 30B – A3B. Стоит отметить, что эти результаты получены на этапе предсерийного производства и могут варьироваться от финальных характеристик готового продукта.
Эффективная миграция в HPC через SYCL
Одним из ключевых аргументов в пользу D270 в сфере высокопроизводительных вычислений (HPC) является простота переноса рабочих нагрузок. На примере демонстрационного проекта Veridien (сейсмическая визуализация) было показано, что использование открытой модели программирования SYCL позволяет мигрировать существующие нагрузки с HIP/CUDA с минимальными усилиями. Благодаря компиляции ahead-of-time (AOT) и использованию бандлов ядер, разработчикам удалось перенести приложение менее чем за месяц.
Важно подчеркнуть, что перенос не потребовал глубокой переработки кода: 90% ядер работали корректно без специфических оптимизаций под Intel, а сложные ядра на первом этапе (без ручной настройки) достигали до 70% от теоретической пиковой производительности. Это делает D270 сбалансированным ускорителем, объединяющим возможности FP64 (числа с плавающей запятой двойной точности) и большой объем памяти для конвергирующих задач ИИ и HPC.
Переход от традиционных вычислений на CPU к гетерогенным системам, где графические ускорители берут на себя наиболее ресурсозатратные задачи, — это не просто тренд, а необходимость для современного HPC (High-Performance Computing). В этом контексте Intel позиционирует свой GPU D270 не просто как очередной ускоритель, а как ключевой элемент, способный закрыть разрыв между стандартными серверными задачами и потребностями суперкомпьютерных вычислений.
Архитектурные преимущества и пропускная способность
Одной из критических проблем в высокопроизводительных вычислениях является «узкое место» памяти. Intel GPU D270 спроектирован с учетом этих требований: использование высокоскоростной памяти с высокой пропускной способностью позволяет минимизировать задержки при передаче огромных массивов данных, что критически важно для моделирования сложных физических процессов, метеорологических прогнозов и задач молекулярной динамики.
Важно понимать, что производительность в задачах HPC не ограничивается только «сырой» мощностью ядер. Intel делает акцент на эффективности передачи данных между процессором и GPU, а также на оптимизации работы с памятью, что позволяет достигать более стабильных результатов в реальных рабочих нагрузках по сравнению с решениями, ориентированными исключительно на графический рендеринг.
Программная экосистема: роль OneAPI
Железо само по себе не решает задачу, если разработчики не могут эффективно использовать его потенциал. Здесь в игру вступает программная база Intel. Использование стандарта OneAPI позволяет разработчикам писать код, который может работать на различных типах ускорителей (CPU, GPU, FPGA) без необходимости полной переработки алгоритмов под конкретную архитектуру. Это значительно снижает порог входа для исследовательских институтов и дата-центров, которые уже используют инфраструктуру Intel.
Такой подход к программному обеспечению решает одну из главных проблем индустрии — фрагментацию кода. Вместо того чтобы оптимизировать каждый алгоритм под конкретный проприетарный API, разработчики получают возможность использовать единую модель программирования, что ускоряет цикл разработки и внедрения новых научных моделей в реальные вычисления.
Масштабируемость и интеграция в дата-центры
Intel подчеркивает, что D270 предназначен для бесшовной интеграции в существующие серверные архитектуры. Это означает, что внедрение ускорителя не требует полной замены текущего парка оборудования. Возможность масштабирования вычислительных мощностей путем добавления модулей GPU позволяет дата-центрам гибко управлять ресурсами, выделяя больше мощности под конкретные задачи (например, обучение нейросетей или сложные симуляции) в зависимости от текущей нагрузки.
Однако стоит учитывать, что реальная эффективность использования D270 в HPC-задачах напрямую зависит от оптимизации конкретного программного стека и конфигурации системы. Intel отмечает, что результаты могут варьироваться в зависимости от используемых библиотек, конфигурации памяти и специфики нагрузки, поэтому при планировании инфраструктуры необходимо опираться на профильные бенчмарки для конкретных приложений.