Архитектура Zen 6: подробный разбор новой платформы AMD
AMD официально представила архитектуру Zen 6, которая станет основой следующего поколения процессоров компании. В то время как серверные решения серии EPYC 9006 на базе этой архитектуры уже начали поступать в продажу, внимание геймеров приковано к будущим процессорам Ryzen. В этом материале мы детально разберем технические изменения в микроархитектуре, основываясь на данных архитектурной сессии AMD в Лас-Вегасе.
10 ноября 2026 года AMD официально представила серию процессоров EPYC 9006 для серверов и дата-центров под кодовым названием Venice. Это важный момент для индустрии: впервые в истории архитектура Zen была представлена в серверном сегменте раньше, чем в потребительском. На данный момент поставки моделей для сокета SP7 уже начались, в то время как решения для SP8 ожидаются не ранее 2027 года. Такая стратегия продиктована колоссальным спросом на вычислительные мощности для задач искусственного интеллекта.
Несмотря на то что AMD пока не делает официальных заявлений о потребительских процессорах Ryzen на базе Zen 6, архитектурные изменения уже стали известны. Мы подготовили глубокий технический разбор, опираясь на информацию, полученную в ходе презентации архитектуры в Лас-Вегасе. Важно понимать: на данный момент детальные диаграммы были опубликованы только для компактной версии ядер — Zen 6c, однако они позволяют составить полное представление о новой структуре.
Две версии ядер: Zen 6 и Zen 6c
Как и в предыдущем поколении, Zen 6 будет представлена в двух вариантах: стандартных ядрах Zen 6 и их компактной версии Zen 6c. Однако между ними пролегает фундаментальная разница в подходе к проектированию. Если Zen 5c была практически идентична основной версии, но с уменьшенным объемом кэша SRAM для экономии площади и энергии, то Zen 6 и Zen 6c имеют разные цели.
Согласно объяснениям Майка Кларка (Mike Clark), ведущего архитектора Zen в AMD, ядра Zen 6 спроектированы с упором на высокие тактовые частоты, что должно обеспечить минимальные задержки и высокую производительность в однопоточных задачах. В то же время ядра Zen 6c ориентированы на максимальную эффективность выполнения инструкций за такт (IPC) при низком энергопотреблении, что делает их идеальными для плотной компоновки в многоядерных системах.
Технические характеристики и производство
Оба типа ядер будут производиться по техпроцессу TSMC N2P (2-нм класс). Архитектура демонстрирует значительный разрыв в плотности ядер на один кристалл (CCD): если стандартный Zen 6 содержит 12 ядер (24 потока с поддержкой SMT), то Zen 6c предлагает 32 ядра (64 потока). Это подтверждается и примерными размерами кристаллов: CCD для Zen 6 составляет около 80 мм², а для Zen 6c — около 160 мм².
Для связи кристаллов (CCD) с центральным I/O-диском (IOD) AMD планирует использовать технологию Elevated Fan-out Bridge (EFB). Эта технология, впервые примененная в GPU Instinct MI200, является более дешевой альтернативой методам CoWoS от TSMC или Foveros от Intel, что делает её крайне перспективной для массового рынка потребительских процессоров Ryzen.
Фронтенд: расширение возможностей декодирования
Анализ фронтенда показывает, что AMD решила не менять базовые параметры выборки инструкций (32 байта на две системы), но значительно усовершенствовала механизмы предсказания и кэширования. В частности, был расширен стек адресов возврата (RAS) с 52 до 64 записей, а также увеличен объем очереди предсказания ветвлений (Branch Prediction Queue) для работы с разросшимися окнами внеочередного выполнения.
Ключевым изменением стал редизайн кэша микроопераций (Op Cache). Его пропускная способность выросла с 12 микроопераций (μOP) за такт в Zen 5 до 18 μOP в Zen 6. Хотя общее количество хранимых микроопераций в кэше может казаться сопоставимым из-за изменения правил измерения, AMD внедрила технологию Increased Op Fusion. Она позволяет объединять несколько x86-инструкций в одну эффективную микрооперацию, что компенсирует изменения в структуре и позволяет обрабатывать больше инструкций за один цикл.
Планировщик и исполнительные блоки: гибкость вместо жестких рамок
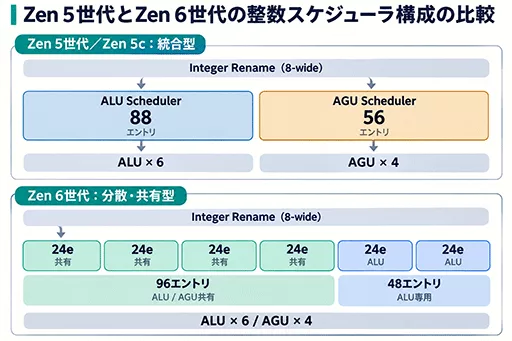
Самое радикальное изменение коснулось планировщика (Scheduler). В Zen 5 архитектура была разделена на два жестких блока: 88 записей для целочисленных операций (ALU) и 56 записей для генерации адресов (AGU). В Zen 6 AMD перешла к гибкой модели: теперь имеется 144 записи, распределенные по шести блокам по 24 записи в каждом. Четыре блока (96 записей) могут работать как с ALU, так и с AGU, а оставшиеся два (48 записей) зарезервированы исключительно под ALU.
Такая архитектура позволяет процессору динамически перераспределять ресурсы. Если текущая нагрузка требует больше вычислений адресов памяти, планировщик может задействовать общие блоки. Если же преобладают математические вычисления, ресурсы смещаются в сторону ALU. Это решение позволяет эффективно использовать транзисторы в зависимости от характера нагрузки — будь то игры, серверные приложения или задачи ИИ.
Оптимизация исполнительных блоков и планировщиков
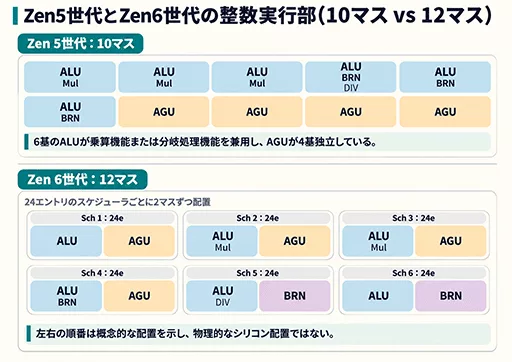
В архитектуре Zen 6 количество ALU (арифметических логических устройств) и AGU (арифметико-логических устройств для работы с адресами) осталось на уровне Zen 5 — по 6 и 4 соответственно. Однако структура управления ими изменилась. Если в Zen 5 блоки ветвления (BRN) были объединены с ALU, что создавало риск конкуренции между целочисленными вычислениями и инструкциями ветвления, то в Zen 6 выделено два независимых блока BRN. Это позволяет обрабатывать ветвления и целочисленные операции параллельно.
При этом количество умножителей (multipliers) сократилось с 3 до 2. Это решение может быть продиктовано как снижением частоты использования умножителей в современном ПО, так и стремлением сэкономить площадь кристалла. Данное изменение связано с реструктуризацией исполнительных блоков в 6 блоков для соответствия 144-записному планировщику.
Расширение окна внеочередного выполнения
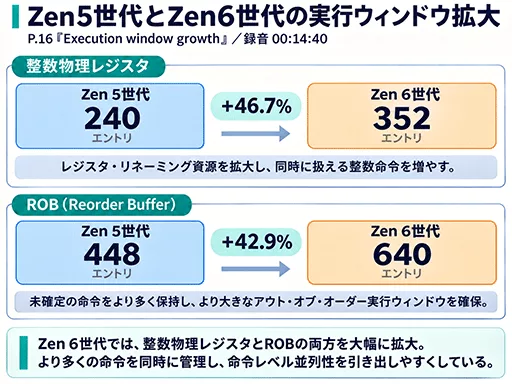
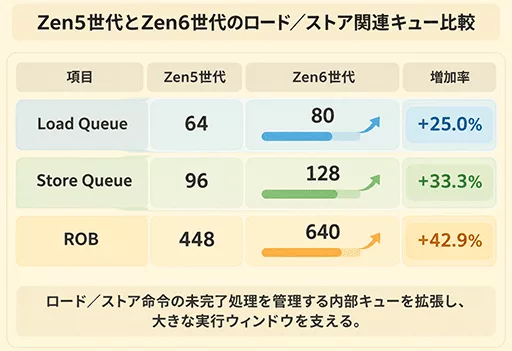
Для повышения эффективности внеочередного (out-of-order) выполнения AMD значительно увеличила объемы ключевых структур. Количество записей в физическом регистровом файле (PRF) и размер переупорядочивающего буфера (ROB) выросли более чем в 1,4 раза по сравнению с Zen 5. Это расширяет диапазон переупорядочивания инструкций, повышая коэффициент использования суперскалярных исполнительных блоков и, как следствие, IPC (количество инструкций за такт).
Различия между Zen 6 и Zen 6c: компромисс частоты и IPC
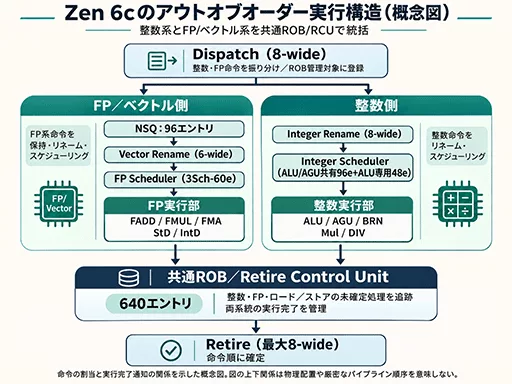
Важным отличием является подход к планировщикам плавающей запятой (FP). В то время как в Zen 6 и Zen 6c структура блоков схожа, их емкость различается. В Zen 6 планировщики FP имеют по 46 записей (всего 138), а в Zen 6c — по 60 записей (всего 180). Как пояснил представитель AMD Кларк, это результат компромисса между частотой, IPC, энергопотреблением и площадью кристалла. Zen 6 ориентирована на высокие частоты (до 5,3 ГГц), что требует более мелкой сегментации блоков для минимизации задержек. Zen 6c, с ограничением частоты до 4,1 ГГц, позволяет использовать более массивные планировщики для максимизации IPC.
Улучшения в работе с памятью и SIMD
Архитектура Zen 6 получила серьезные улучшения в конвейере Load/Store. Теперь процессор способен выполнять четыре 256-битные операции загрузки (Load) за один такт, тогда как в Zen 5 этот показатель составлял две операции. Это потенциально удваивает пиковую производительность загрузки в задачах, использующих инструкции AVX2. При этом производительность записи (Store) осталась на уровне Zen 5 (одна 512-битная или две 256-битные операции за такт), а улучшения в этой области перенесены на следующее поколение.
Также расширены очереди загрузки и выгрузки (Load/Store Queues): очередь загрузки выросла с 64 до 80 записей, а очередь выгрузки — с 96 до 128. Это напрямую связано с увеличением размера ROB и направлено на повышение параллелизма на уровне памяти (MLP), позволяя процессору эффективнее обрабатывать промахи кэша и скрывать задержки обращения к основной памяти.
Новые возможности векторных вычислений
- Нативная поддержка матричного умножения (Bit Matrix Multiply, BMM).
- Полная нативная поддержка FP16 в наборе инструкций AVX-512.
- Расширение поддержки VNNI-INT8: теперь все 4 конвейера FP могут выполнять операции с 8-битными целыми числами (в Zen 5 работали только 2 из 4).
Эволюция кэш-памяти и CCD
Структура кэша Zen 6 демонстрирует рост масштабов: количество ядер на один чиплет (CCD) и объем L3-кэша на один CCD увеличились в 1,5 раза по сравнению с Zen 5. В версии Zen 6c этот рост еще более впечатляющий: количество ядер на CCD удваивается, а объем L3-кэша увеличивается в 4 раза (до 128 МБ). При этом AMD сохранила архитектуру Victim Cache для L3 и оптимизировала управление префетчем в кэше L2, чтобы избежать конфликтов с обычными запросами на чтение при высокой интенсивности работы ядер.
В основе новой стратегии AMD лежит глубокое архитектурное различие между флагманскими процессорами Zen 6 и их энергоэффективными версиями Zen 6c. Согласно анализу, это не просто программная настройка, а фундаментальное разделение на уровне дизайна ядер, призванное максимально эффективно решать задачи в разных сценариях использования.
Разделение на уровне архитектуры
Ключевым аспектом новой линейки является использование специализированных ядер Zen 6c. В отличие от стандартных моделей, версия «c» (compact) ориентирована на работу в условиях ограниченного тепловыделения и энергопотребления. Это достигается за счет оптимизации физических параметров ядер, что позволяет сохранять высокую плотность вычислений при меньших затратах энергии.
Такой подход позволяет AMD гибко подходить к сегментации рынка:
Значение для индустрии
Разделение архитектур на уровне дизайна позволяет AMD более точно конкурировать с решениями, ориентированными на мобильный сегмент, обеспечивая при этом беспрецедентную масштабируемость. Это означает, что программная совместимость между сериями будет сохранена, но физическая реализация ядер будет оптимизирована под конкретные цели: либо чистая мощь, либо максимальная автономность.