Intel готовит инфраструктуру для ИИ-агентов: новые GPU и Xeon-стойки
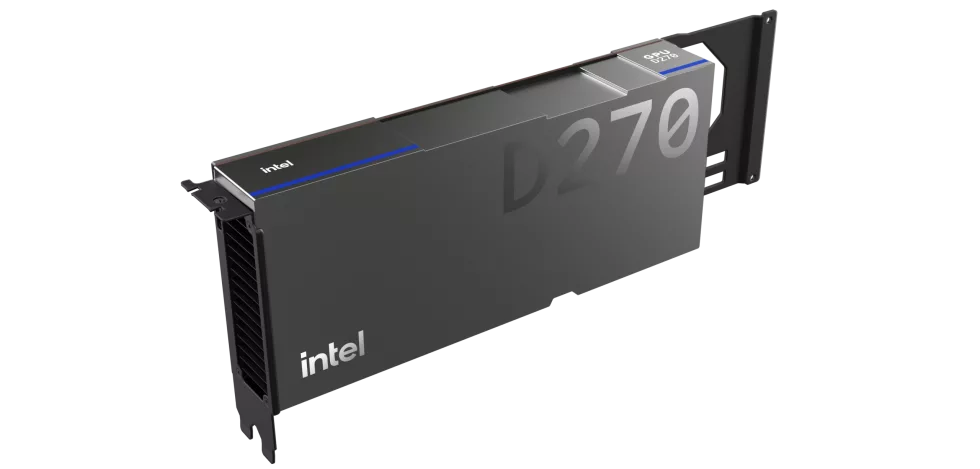
На прошедшем Open Compute Project Global Summit 2026 компания Intel обозначила свой вектор развития в эпоху «агентного» ИИ. Вместо того чтобы фокусироваться только на чистом расчете нейросетей, вендор делает ставку на инфраструктуру, способную поддерживать сложные многоступенчатые процессы: от сбора данных и логических выводов до выполнения задач ИИ-агентами. Ключевыми элементами этой стратегии стали новая серия GPU под кодовым названием Crescent Island и высокоплотные серверные решения на базе процессоров Xeon.
Гетерогенный подход: CPU как дирижер, GPU как исполнитель
Главная идея Intel заключается в том, что ИИ-агенты требуют не только огромных вычислительных мощностей, но и эффективного управления данными и памятью. В этой схеме процессоры Xeon берут на себя роль «оркестратора»: они отвечают за общие вычисления, координацию шагов агента и перемещение данных, в то время как специализированные ускорители занимаются непосредственно математикой нейросетей. Такой подход позволяет оптимизировать затраты, направляя каждый запрос (prompt) на наиболее подходящий ресурс.
Для реализации этой концепции Intel представила проекты стоек, ориентированные на стандарт Open Rack v3 (ORv3). В конфигурациях на базе процессоров Xeon 6+ плотность вычислений достигает невероятных показателей: заявлено более 46 000 ядер и суммарная мощность в 133,45 кВт на одну стойку. Стоит отметить, что это проектные показатели для выбранных конфигураций, а не фиксированные спецификации для всех систем.
GPU-серия Crescent Island: ставка на инференс и память
Одной из самых ожидаемых новинок стала серия GPU-D, известная под кодовым именем Crescent Island. Она построена на архитектуре Xe3P и нацелена на задачи инференса (вывода) — то есть на работу уже обученных моделей, особенно больших языковых моделей (LLM) с длинным контекстом. Технические характеристики впечатляют: до 1,3 петафлопса в формате FP8 при энергопотреблении в 350 Вт и пропускная способность памяти 1,5 ТБ/с.
Особое внимание уделено объему памяти, что критично для работы с огромными контекстами. Собственная плата Intel на интерфейсе PCIe получит 160 ГБ памяти LPDDR5X. Однако компания оставляет пространство для партнеров (ODM): сторонние производители смогут предлагать свои версии карт с увеличенным объемом памяти — вплоть до 480 ГБ. Это позволит обрабатывать модели с объемом до 300 миллиардов параметров на одной карте или более триллиона параметров в системе из восьми GPU.
Программная экосистема и открытые стандарты
Железо без софта в ИИ-сфере бесполезно, и Intel активно работает над тем, чтобы упростить переход разработчиков на свои платформы. Компания продвигает единую программную базу Xe, которая должна обеспечить переносимость приложений между различными GPU. Кроме того, Intel активно участвует в работе Open Compute Project, в том числе в группе по разработке стандартизированных адаптерных карт (Open Adapter Card), чтобы ускорители могли легко интегрироваться в различные серверные архитектуры без переделки всей инфраструктуры.
На данный момент идет процесс тестирования (customer sampling) серии GPU-D, а точные сроки выхода в широкую продажу пока не объявлены.
Гика